论文分组柱状图怎么画:matplotlib 完整代码 + 用 CSV 一步生成
一份可直接复制运行的 matplotlib 分组柱状图方案:长格式 CSV、误差线、色盲友好配色、按栏宽设置尺寸、嵌入字体,以及最常见排版问题的解决办法。
分组柱状图(也叫簇状柱形图)是论文里比较“多个方法 × 多个数据集”的标准画法:每个数据集一组,每个方法一根柱子。几乎每篇论文的实验部分都会用到它,但它也特别容易出小毛病:标签挤在一起、误差线把数字挡住、图例盖住柱子,或者导出的 PDF 过不了会议的字体检查。
这篇文章给出一段可以直接复制运行的 matplotlib 脚本,讲清楚其中对论文真正重要的设置,并列出最常见问题的修法。文末还有一个更省事的办法:直接用 CSV 加一句话描述生成。
什么时候适合用分组柱状图
适合的情况:
- 比较少量方法(通常 2–5 个)在少量类别(数据集、任务、模型规模)上的表现。
- 类别是离散的。如果横轴是连续量(训练步数、噪声强度),折线图更清楚。
- 读者更关心组内的相对差异,而不是精确数值。如果精确数值最重要,用表格可能更合适,或者像下文那样加上数值标签。
如果每组超过 5 根柱子,或者超过 6 组,可以考虑拆成两张图、改成横向柱状图,或者干脆用表格。
第一步:把数据整理成长格式
每次测量一行。这种“长格式”从实验日志里导出很方便,后续也容易变形:
method,dataset,accuracy,std
Baseline,CIFAR-10,91.2,0.3
Ours,CIFAR-10,94.7,0.2
Ours+Aug,CIFAR-10,95.3,0.2
Baseline,CIFAR-100,68.4,0.5
Ours,CIFAR-100,74.9,0.4
Ours+Aug,CIFAR-100,76.8,0.3
Baseline,Tiny-ImageNet,55.1,0.6
Ours,Tiny-ImageNet,61.8,0.5
Ours+Aug,Tiny-ImageNet,63.5,0.4
以上数字只是本教程的示例数据,不是真实的基准测试结果。
第二步:完整的 matplotlib 脚本
脚本在 matplotlib 3.11 + pandas 下测试通过,会同时输出 LaTeX 用的矢量 PDF 和 300 DPI 的 PNG。
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd

df = pd.read_csv("results.csv")
datasets = ["CIFAR-10", "CIFAR-100", "Tiny-ImageNet"]  # x-axis order
methods = ["Baseline", "Ours", "Ours+Aug"]              # bar order in each group

mean = df.pivot(index="dataset", columns="method", values="accuracy").loc[datasets, methods]
std = df.pivot(index="dataset", columns="method", values="std").loc[datasets, methods]

plt.rcParams.update({
    "font.family": "serif",
    "font.size": 9,
    "axes.spines.top": False,
    "axes.spines.right": False,
    "pdf.fonttype": 42,   # embed TrueType fonts (many venues require this)
    "ps.fonttype": 42,
})

colors = ["#0072B2", "#E69F00", "#009E73"]  # Okabe-Ito, colorblind-safe
hatches = ["", "//", "xx"]                  # still readable in grayscale

x = np.arange(len(datasets))
n = len(methods)
width = 0.8 / n

fig, ax = plt.subplots(figsize=(3.5, 2.6))  # single-column width in inches
for i, method in enumerate(methods):
    offset = (i - (n - 1) / 2) * width
    ax.bar(
        x + offset, mean[method], width,
        yerr=std[method], capsize=2, error_kw={"elinewidth": 0.8},
        label=method, color=colors[i], hatch=hatches[i],
        edgecolor="black", linewidth=0.5,
    )
    # Put value labels above the error bar, not on top of it.
    for xi, m, s in zip(x + offset, mean[method], std[method]):
        ax.text(xi, m + s + 1.5, f"{m:.1f}", ha="center", va="bottom", fontsize=5.5)

ax.set_xticks(x, ["CIFAR-10", "CIFAR-100", "Tiny-\nImageNet"])  # wrap long names
ax.set_ylabel("Top-1 accuracy (%)")
ax.set_ylim(0, 105)
ax.yaxis.grid(True, linestyle=":", linewidth=0.5)
ax.set_axisbelow(True)
ax.legend(loc="upper center", bbox_to_anchor=(0.5, -0.24), ncol=n, frameon=False)

fig.tight_layout()
fig.savefig("grouped_bar.pdf", bbox_inches="tight")            # vector, for LaTeX
fig.savefig("grouped_bar.png", dpi=300, bbox_inches="tight")   # raster, 300 DPI
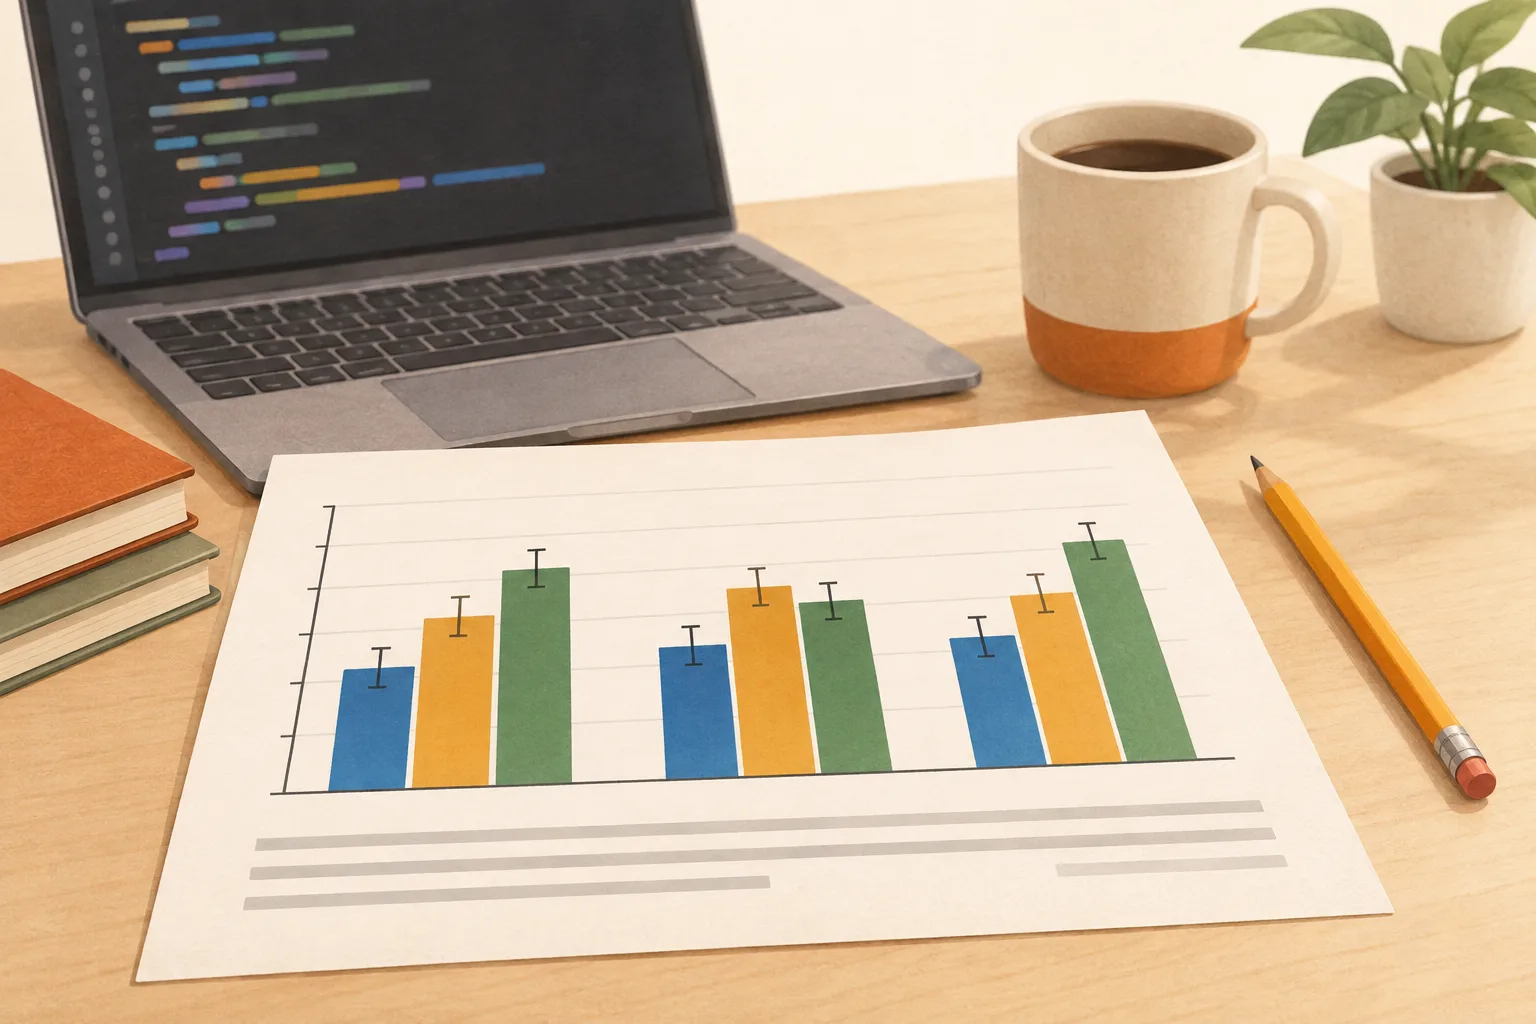
运行结果(300 DPI):

关键设置说明
偏移公式。 每个方法的柱子平移 (i - (n - 1) / 2) * width,不管有几个方法,整组柱子都会以刻度为中心。配合 width = 0.8 / n,一组柱子占刻度间距的 80%,组与组之间留出空隙。
显式指定顺序。 pivot(...).loc[datasets, methods] 固定了组和柱子的顺序。不写的话 pandas 会按字母排序,你自己的方法往往会排到奇怪的位置。
颜色和纹理。 三种颜色取自 Okabe–Ito 配色,对最常见的几类色觉障碍都能区分;纹理(hatch)保证黑白打印时也分得清。
用英寸而不是像素定尺寸。 figsize=(3.5, 2.6) 对应大多数双栏模板的单栏宽度(约 3.3–3.5 英寸)。按最终尺寸作图,matplotlib 里的 9 pt 字号在 PDF 里也是 9 pt,和正文字号接近。通栏图用约 7 英寸宽。
嵌入字体。 pdf.fonttype: 42 让 matplotlib 嵌入 TrueType 字体而不是 Type 3 字体。很多会议的投稿检查会标记 Type 3 字体,这一行可以避免这个问题。
优先用矢量图。 在 LaTeX 里用 \includegraphics[width=\columnwidth]{grouped_bar.pdf} 插入 PDF;300 DPI 的 PNG 留给幻灯片、Word 或要求位图的期刊。
常见问题及修法
下面是同一份脚本修复排版之前的第一版:

能看到三个问题,也是大家最常遇到的:
- 横轴标签重叠。 单栏宽度下,长类别名会挤在一起。可以用
\n换行、缩写(在图注里说明),或者旋转:ax.set_xticks(x, labels, rotation=20, ha="right")。 - 数值标签挡住误差线。
ax.bar_label把文字放在柱顶,而误差线正好从柱顶开始。像最终脚本那样把标签放到mean + std再往上一点,或者不加数值标签、改在表格里给数字。 - 数字太挤。 相邻标签贴在一起时,缩小字号、只保留一位小数,或者每组只标最好的结果。
其他值得检查的地方:
- 图例盖住柱子。 像上面那样用
bbox_to_anchor移到坐标轴下方,或者放到图上方:loc="lower center", bbox_to_anchor=(0.5, 1.0)。 - 纵轴不从 0 开始。 柱子的长度代表数值,截断纵轴会夸大差异。如果差异很小但很重要,用点图或表格展示,不要截断坐标轴。
- 误差线没有说明。 在图注里写清楚误差线表示标准差、标准误还是 95% 置信区间,以及基于几次运行。
- PDF 里的图发糊。 通常是把低分辨率 PNG 放大了。用矢量 PDF,或者按最终打印尺寸、至少 300 DPI 导出 PNG。
投稿前检查清单
- 组和柱子的顺序是有意安排的(读者能一眼找到你的方法)。
- 配色对色盲友好,黑白打印也能区分。
- 按最终打印宽度,图中字号和图注字号接近。
- 坐标轴标签带单位,纵轴从 0 开始。
- 图注说明了误差线的含义和运行次数。
- 字体已嵌入(PDF 中没有 Type 3 字体)。
- 同一个方法在论文所有图里都用同一种颜色。
想用 seaborn?
如果数据已经是长格式,seaborn 一行就能画出同样的分组:
import seaborn as sns

ax = sns.barplot(data=df, x="dataset", y="accuracy", hue="method",
                 palette=["#0072B2", "#E69F00", "#009E73"], errorbar=None)
每个测量只有一行、没有重复运行时,设 errorbar=None。如果 CSV 里每次运行一行,seaborn 可以自己算误差线(例如 errorbar="sd")。尺寸、字体和导出设置仍然建议沿用上面的脚本。
更省事的办法:用 PaperBanana 从 CSV 直接出图
如果不想自己写和调试画图代码,PaperBanana Paper Visualizer 的数据图模式就是为这种场景做的:
- 粘贴 CSV 或 JSON 数据。
- 用一句话描述想要的图,例如:“按数据集画准确率的分组柱状图,每个方法一根柱子,柱顶标数值,图例放在横轴下方。”
- PaperBanana 会生成 matplotlib 代码,在隔离沙箱里运行,以 300 DPI 渲染出图,再由评审 agent 检查一轮或多轮。
图片可以直接下载,生成的代码也可以一键复制,所以你可以在本地重新运行、导出矢量 PDF、按需修改。下面是用本文同一份数据实际生成的结果:

数据图模式不使用图像模型,图里的数字直接来自你的数据。每轮评审 10 积分,用不到的轮次会自动退回。详见价格页。
常见问答
用分组柱状图还是表格? 想传达的是一种规律时用图,比如“我们的方法在所有数据集上都更好”“数据集越难差距越大”;读者需要精确数值时用表格。很多论文两者都用:正文放图,附录放完整表格。
每组几根柱子算太多? 单栏宽度下,每组超过 5 根就不好读了。可以拆成两张图,或者把次要的基线放到附录。
用标准差还是标准误? 都可以,关键是写明用的是哪个。标准差反映多次运行之间的波动;标准误和置信区间反映均值估计得有多准。一定要写运行次数。
能画成横向的吗?
可以。把 ax.bar 换成 ax.barh,交换横纵轴,用 ax.set_yticks。类别名很长时,横向柱状图更好读。
论文配图的通用建议,可以看如何为研究论文制作出版级配图,以及 TikZ、matplotlib 与 AI 工具的对比。
更多文章

PaperBanana 如何用 AI 革新学术插图创作
深入解析 PaperBanana 背后的 5-Agent 框架,这个 AI 驱动的系统正在改变研究人员创建科学插图的方式。了解方法论图表生成、统计图表创建和草图润色的技术细节。

TikZ vs Matplotlib vs AI:2026 年学术论文配图最佳工具指南
一份关于学术论文配图工具的客观对比。我们从学习曲线、输出质量和工作流效率三个维度,全面比较了 TikZ、matplotlib、draw.io、Figma、BioRender 以及 PaperBanana 等 AI 生成工具。
PaperBanana 重新上线:GPT Image 2.6、Nano Banana 2.1 与 Plot 模式
2026 年 11 月 10 日,PaperBanana 重新上线:两种图像模型、2K 插图、隔离沙箱内的 300 DPI 统计图,以及按轮预扣、未使用轮次自动退款。
保持关注
加入 PaperBanana 社区
获取新功能通知、科研技巧和早期体验机会